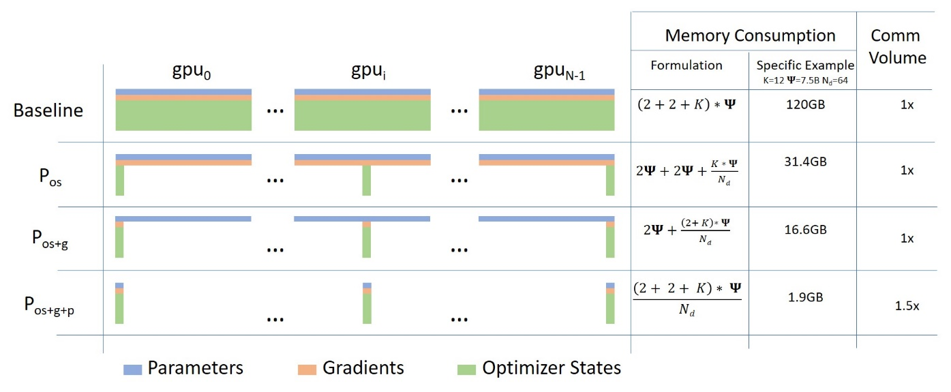
New releaseFit More and Train Faster With ZeRO via DeepSpeed and FairScaleHugging Face Blog · 1 min read
New releaseHow we sped up transformer inference 100x for 🤗 API customersHugging Face Blog · 1 min read
New releaseLeveraging Pre-trained Language Model Checkpoints for Encoder-Decoder ModelsHugging Face Blog · 1 min read
New releaseBlock Sparse Matrices for Smaller and Faster Language ModelsHugging Face Blog · 1 min read